NOAI上机题应先读任务目标、字段说明与提交格式,再检查数据类型、标签和文件分工,最后建立可验证的处理流程。从第三届开始报名仅面向高中生,新赛季具体赛程待定。

一、打开文件前,先找出题目让你解决什么?
NOAI第二轮涉及真实AI任务,相关技能包含NumPy、Pandas、Matplotlib、scikit-learn和PyTorch等。会调用模型只是其中一环;如果把预测目标读错、把编号当成有效特征,或者输出格式不符合要求,即使程序能够顺利运行也未必完成了题目。
任务说明应先于数据操作。先确认目标是分类、数值预测、图像处理还是其他问题,再找到评分指标、可用文件与限制条件。不要只凭文件名中出现train或test就跳过说明,也不能默认每道题都提供标签、都采用同一种划分方式。
可以把读到的信息压缩成三句话:输入包含什么,程序需要产生什么,以及结果用什么方式评估。若其中一项仍说不清,先返回题目寻找对应条件。此时贸然清洗数据或选择复杂模型,容易把时间花在与目标无关的工作上。
二、字段不是越多越好,应该怎样逐列判断?
读入表格后先检查行列数量、列名、类型和少量样本。Pandas的read_csv可以通过dtype控制字段类型,也能通过na_values指定需要识别为空值的表示;这些参数应根据字段语义选择,不能把每一列都统一转成数字。
| 字段角色 | 阅读时确认的内容 | 常见误处理 |
|---|---|---|
| 样本编号 | 是否唯一、是否含前导零 | 转成整数后破坏编号或提交匹配 |
| 输入特征 | 单位、取值范围、记录含义 | 混合不同单位,误把缺失视为真实零 |
| 目标标签 | 预测对象与类别含义 | 将标签并入输入,造成信息泄漏 |
| 时间或分组字段 | 先后关系、同对象重复记录 | 随机拆分造成验证结果过于乐观 |
例如,编号“0012”与数值12可能并不是同一个表示。编号常用于关联样本和输出,不应只因它由数字组成就直接作为连续数值输入模型。相反,一个取值为0的计数特征可能有真实含义,不能因为它看起来“空”就改为缺失值。
字段含义决定处理方法。发现温度、比例或时长等列时,先核对单位与合理范围;发现类别列时,确认它是有顺序的等级还是无顺序名称。先做这一步,才能判断后续编码、标准化或异常值检查是否适用。
三、训练、验证和测试怎样各司其职?
在常见监督学习练习中,训练数据用于学习,验证数据用于检查模型在未参与拟合的样本上表现如何,测试数据用于生成规定结果。下图是一个自编示例,测试标签不提供;实际NOAI题可能采用其他文件名称、数据结构或评估安排,应按当题说明分配角色。
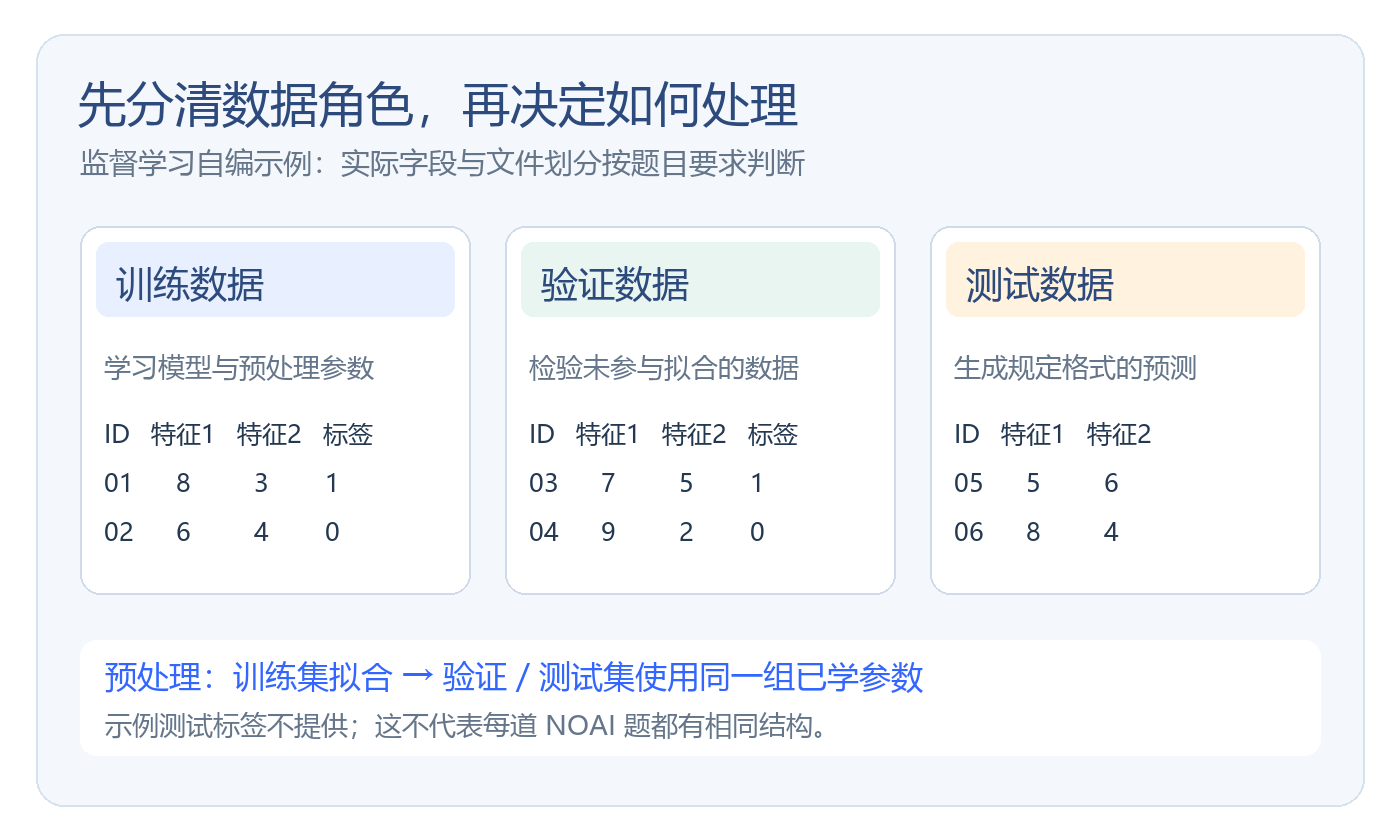
监督学习数据角色自编示意
如果题目已经给出了训练与验证文件,应先理解这样的划分,不要为了增加训练量立即把两者合并。若需要自行从训练数据划分验证集,要考虑同一对象、同一时间段是否重复出现;带时间顺序或组别关联的数据,未必适合逐行随机拆分。
不能把测试数据当成反复调参的答案库。验证集是用来检验选择是否合理的,也不能因不断根据它调整而忽略过拟合。保留清楚的实验记录,说明模型用了哪些数据拟合、哪些数据评估,比分数只保留一个最高值更容易定位问题。
四、缺失、重复和异常值该怎样检查?
先统计每列缺失情况,查看缺失是否集中在某种样本或某个时间区间,再考虑保留、填补或其他处理。直接把全部空值替换成0,会把“未记录”与“数值确实为零”混在一起。处理方法是否合理,还要结合题目中字段代表的实际含义。
对重复行也不要立即全部删除。它可能是采集错误,也可能代表同一对象在不同场景下的真实记录。需要检查编号、时间与标签是否一致;若同一个输入出现不同标签,先寻找任务定义和数据记录方式,而不是任意保留第一条。
异常值检查可以从范围、单位和简单可视化入手。若绝大多数长度以米记录,少数值却看起来像厘米,就应该回到说明判断是否发生了单位混用。图形帮助发现现象,不能单凭“看起来离群”就判定该样本无效。
五、怎样避免预处理时偷偷泄漏信息?
在用验证集评估时,标准化、缺失值填补、特征选择等需要学习数据参数的步骤,应只在训练数据上拟合,再把同一套已学参数应用到验证与测试数据。若先合并所有数据计算均值、筛选特征,再拆回训练和验证,就可能让评估环节提前利用了不应获得的信息。
还应排查那些与答案时间关系不合理的字段。例如,要预测某次事件发生之前的状态,却使用事件结束之后生成的结果列,模型可能看似准确,实际上只是在读取答案的后续记录。判断一个字段能否使用,不能只看它有没有被命名为label。
可以用Pipeline组织适合串联的预处理与模型步骤,减少训练和预测时手工处理不一致的风险。先建立简单基线,确认数据流程正确,再增加复杂度;否则复杂模型带来的性能变化与数据泄漏造成的虚高会混在一起。
六、读懂数据的最后一关是输出校验
提交前逐项检查样本数量、编号顺序、列名和预测取值。若题目给出了样例提交文件,将它作为结构参照,再确认最终输出与实际测试样本一一对应。不要默认分类结果总是从0开始,也不要把内部编码直接当成要求提交的类别名称。
保存CSV时是否使用index=False,要由提交格式决定;多出一列索引或漏掉必要编号,都可能使结果无法正确对应。成功写出文件不等于提交有效。最好重新读取保存后的文件,再确认结构、行数和关键字段与要求一致。
读数据的顺序可以概括为理解目标、辨认字段、安排评估、构建处理流程、核对输出。真正熟练的上机准备,是遇到新数据也能说明每一步为什么这样做,而不是看到表格就机械套用上一份练习的清洗代码。
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
NOAI新赛季备赛已开启,扫码领取NOAI备赛资料
欢迎咨询【NOAI竞赛辅导课程】