避免过拟合,应先保证验证方式可信,再控制模型复杂度和训练过程。训练分数高、验证表现差是重要信号,但也要排查数据泄漏、分布差异和评价错误。NOAI备赛中,比反复追逐一次高分更有价值的,是能说明模型为何能在未见数据上保持表现。

一、先读懂训练成绩与验证成绩的差距
模型对训练样本越来越熟悉,并不意味着对新样本理解得更好。过拟合通常表现为模型过度适应训练数据中的细节或噪声,训练表现继续提高,而独立验证表现停滞甚至下降。诊断时要在相同指标和可比较的数据处理流程下看差距。
自编实验示意:对同一分类任务逐渐增加决策树深度,深度1时训练与验证准确率为78%、76%;深度3时为90%、84%;深度12时为100%、72%。最后一组值得警惕,但这三行示意数据不能单独证明具体原因,仍需检查划分方式和训练记录。
图中用同一条复杂度轴展示这种变化。它是帮助理解的假设数据,不是NOAI真实成绩,也不是“某个树深度最优”的结论。
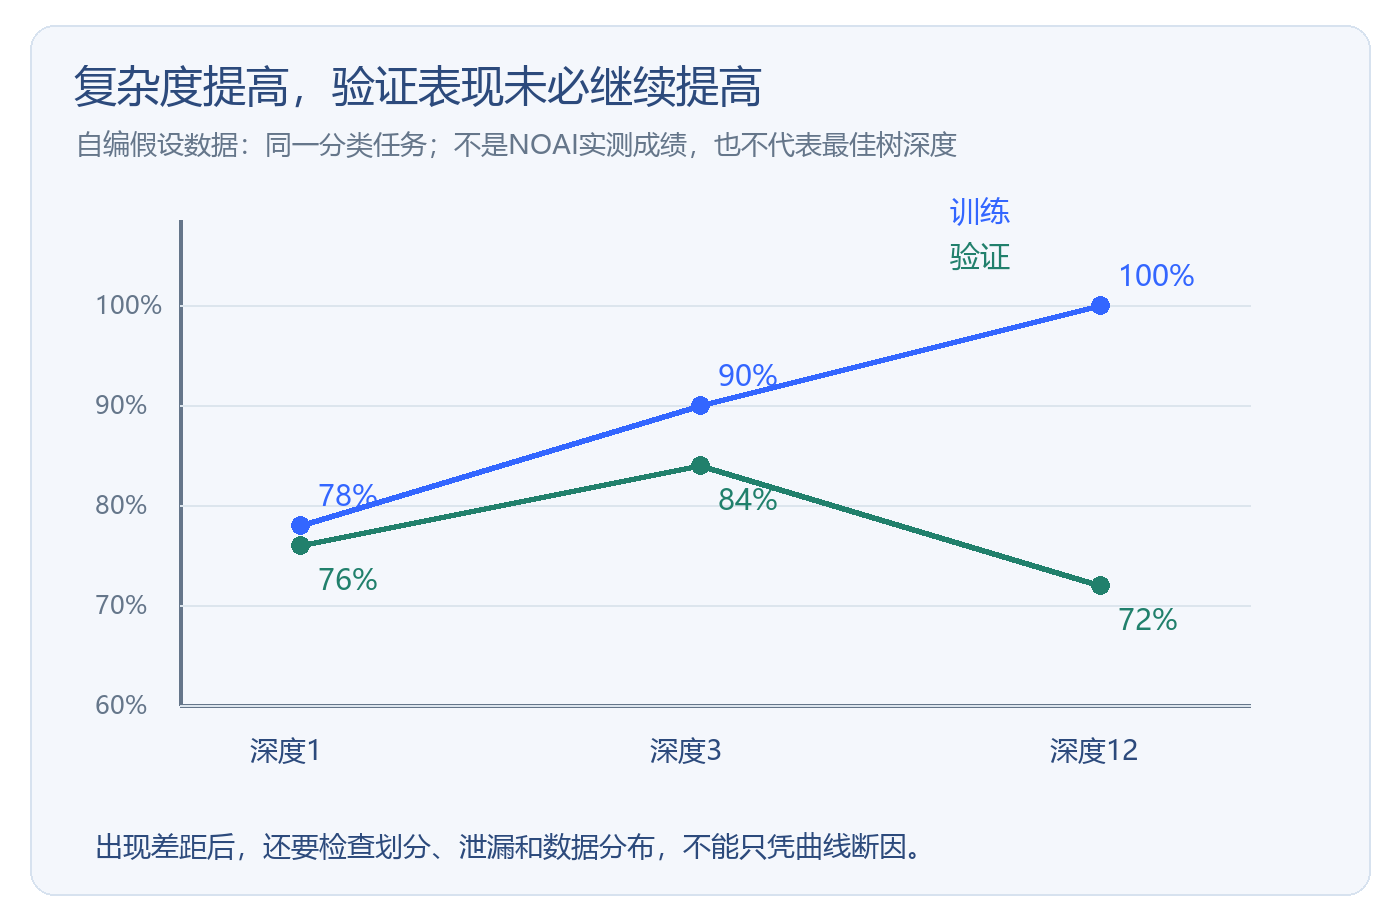
自编假设数据:不同树深度下训练与验证准确率的变化
如果训练和验证分数都低,应先考虑特征、任务理解或模型能力是否不足;如果两者同时异常高,则要怀疑是否存在泄漏。把所有低分都归因于过拟合,可能让原本欠拟合的模型继续被过度简化。
二、数据划分要发生在学习处理参数之前
先划分训练集与验证集,再在训练部分拟合预处理。标准化的均值与方差、缺失值填补规则、特征选择等,只要会从数据中学习参数,就不能提前利用验证样本的信息。学到的转换可以应用于验证数据,但不能反过来用验证数据重新拟合。
例如预测学生某项测评表现时,同一学生多次记录若随机分散到训练和验证两边,模型可能利用个人特征认出对象,得到过分乐观的分数。这类任务应按学生等相关单位考虑分组划分。按时间预测未来的任务,则需要尊重先后关系,避免把未来信息放到过去训练中。
下面列的是常见风险及相应动作。每个动作都需要结合任务设置,不是对所有数据一律随机划分。
| 风险来源 | 容易产生的错觉 | 更稳妥的处理 |
|---|---|---|
| 同一对象的重复样本跨集合 | 像见过答案一样高分 | 按对象分组评估 |
| 全量数据先做特征选择 | 验证集参与决定特征 | 只在训练部分拟合选择器 |
| 根据测试结果持续调参数 | 测试成绩被反复优化 | 用验证集选择,保留最终测试 |
| 时间任务混入未来记录 | 历史预测表现不真实 | 按实际预测时间组织划分 |
交叉验证也不能自动消除泄漏。如果先在全量数据上选特征,再对已经处理好的数据交叉验证,信息仍可能提前流入。使用Pipeline将预处理与模型组合,并在每个训练折内部拟合,是一种减少此类错误的方法。
三、先有简单基线,再增加容量
准备一个能稳定运行、评价方式明确的简单模型,作为比较起点。它不必是最终最高分方案,但应把数据读取、划分、训练、评价连成可重复的实验。随后改变模型复杂度,才能判断新增参数是否带来验证收益。
控制复杂度的方式取决于模型:树模型可限制深度或叶节点规模;线性模型可尝试正则化;神经网络可结合数据量、网络规模和正则化策略调整训练。不要把“参数越少越好”当成目标,简化过度也会损失有效规律。
若有独立验证指标可监控,可以考虑早停:保留验证表现较好的训练阶段,而非默认使用最后一轮。早停监控的是允许用于选择的验证数据,不能拿隐藏测试标签来挑轮数。训练轮数、正则化强度等也需在同一评价口径下比较。
四、给每次实验留下可解释的记录
记录数据版本、划分方式、指标、关键参数及随机设置。固定随机种子有助于复现某次运行,但不能保证泛化,也不能消除所有随机性。若不同划分或不同随机初始化下波动很大,就应把波动纳入判断,不能只保存最高的一次结果。
一次实验尽量只检验一个主要想法,例如“降低树深度能否改善验证分数”。如果同时换数据、改特征、换模型,就难以知道哪一项起作用。结果应至少保留训练与验证指标,并简单说明变化是否符合原假设。
也要防止对验证集本身过拟合。反复尝试大量方案,总挑同一验证集上最高的一个,可能逐渐适应该集合的偶然性。条件允许时可使用合适的交叉验证,并为最终评估保留未参与方案选择的数据;数据很少时,更应克制对微小分差的解读。
五、用错误样本决定下一步
将验证错误按有意义的条件分组,例如类别、输入长度、图像质量或数据来源,检查模型在哪些场景失效。若弱项集中在训练中几乎没有覆盖的情境,补充合法且适合任务的数据可能比单纯加大正则化更有效。
但错误分析不能变成读取测试答案。只使用规则允许、能够参与开发的材料;也不要把验证标签编码进人工特征。学习目标始终是发现可迁移的规律,而不是记住评估样本的身份。
NOAI中国区公开介绍涉及Python、机器学习、深度学习、计算机视觉和自然语言处理等方向。无论练习哪一类任务,都可以把结果说明写完整:划分为何合理、处理参数在哪里拟合、模型选择依据是什么、错误集中在哪里。能回答这四个问题,才更接近可信的模型改进。
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
NOAI新赛季备赛已开启,扫码领取NOAI备赛资料
欢迎咨询【NOAI竞赛辅导课程】