调试学习率先固定数据、模型和评价方法,再比较不同步长的损失曲线。NOAI相关训练中,损失下降慢不一定只因学习率太小;先排除数据与梯度问题,才能让每次调整有明确依据。

一、先弄懂学习率改变了什么
以最简单的梯度下降为例,参数的新值等于旧值减去学习率乘以当前梯度。梯度给出局部变化方向,学习率控制沿这个方向走多远。它不是训练准确率,也不是每次会修正多少道题,更不能把数值大小直接理解成模型聪明程度。
考虑自编函数L(w)=(w-3)²,梯度为2(w-3)。从w=0开始,若学习率为0.1,第一次更新到0.6;若学习率为0.5,第一次更新到3。这个例子刻意很简单,用来观察步长效应,不能由此推出0.5适合真实神经网络。
神经网络的损失面、优化器和数据规模远比这个单变量例子复杂。SGD与Adam中同样的学习率,也不能简单当作完全等价的更新幅度。调参记录要同时写明优化器名称及关键设置,否则数字离开环境就失去参考价值。
二、先排查不会被调学习率解决的问题
在NOAI备赛实验中,如果训练损失一直不动,先检查参数是否被交给优化器、是否调用反向传播和更新步骤、是否误把训练段包在不记录梯度的上下文里。再确认输入和标签能对应,目标类型与损失函数兼容。
还可以用很小的一部分训练数据做诊断:如果模型连少量样本都难以拟合,就优先检查流程、模型容量或数据问题。这个实验不是正式成绩,不能用它替代独立验证集评价;它的价值是缩小故障范围。
观察数值也很重要。损失变成NaN或无穷时,可能是学习率过大,也可能来自非法输入、除零或数值溢出。先找第一次出现异常的位置,比直接把学习率连续除以十更有解释力。
三、用同一个起点比较候选值
先保存模型初始参数,并固定训练与验证划分。每个候选学习率都从相同初始权重重新开始,同时重置优化器状态;不能让第二组接着第一组已经训练过的模型继续跑,否则比较中混入了训练进度差异。
候选值可以按数量级拉开,例如在既定基线附近比较三个步长。具体数字应结合优化器和任务确定,不把某一组合包装成竞赛标准答案。使用相同的批量大小、更新步数与评价间隔,才知道变化主要来自哪里。
| 观察到的现象 | 可能解释 | 下一步检查 |
|---|---|---|
| 训练损失大幅震荡 | 步长过大,也可能批次噪声大 | 固定数据顺序并看多次更新趋势 |
| 训练损失下降很慢 | 步长偏小或梯度很弱 | 查看梯度与参数更新是否发生 |
| 训练变好,验证变差 | 过拟合或评价流程问题 | 检查划分与训练、评估模式 |
| 损失出现非有限值 | 更新或数据计算异常 | 定位首个异常运算 |
不要只截取最后一个batch的损失作为整轮结果。批次组成不同会影响数值;应采用一致的汇总口径,例如按样本数加权的平均损失,并保留必要的逐步记录,帮助判断异常发生在何时。
四、把曲线与参数更新放在一起看
回到前面的单变量例子,学习率0.1时,误差w-3每步乘0.8,逐渐接近零;学习率1时,误差每步乘-1,会在两侧来回摆动而不缩小;学习率1.1时,误差绝对值每步扩大为1.2倍。这个对照让“太大”变成可以计算的行为。
下图显示相同初始点、不同步长的误差变化规律。真实模型未必呈现这样规则的轨迹,但比较实验仍应保留“相同起点、相同过程、同一指标”的原则。
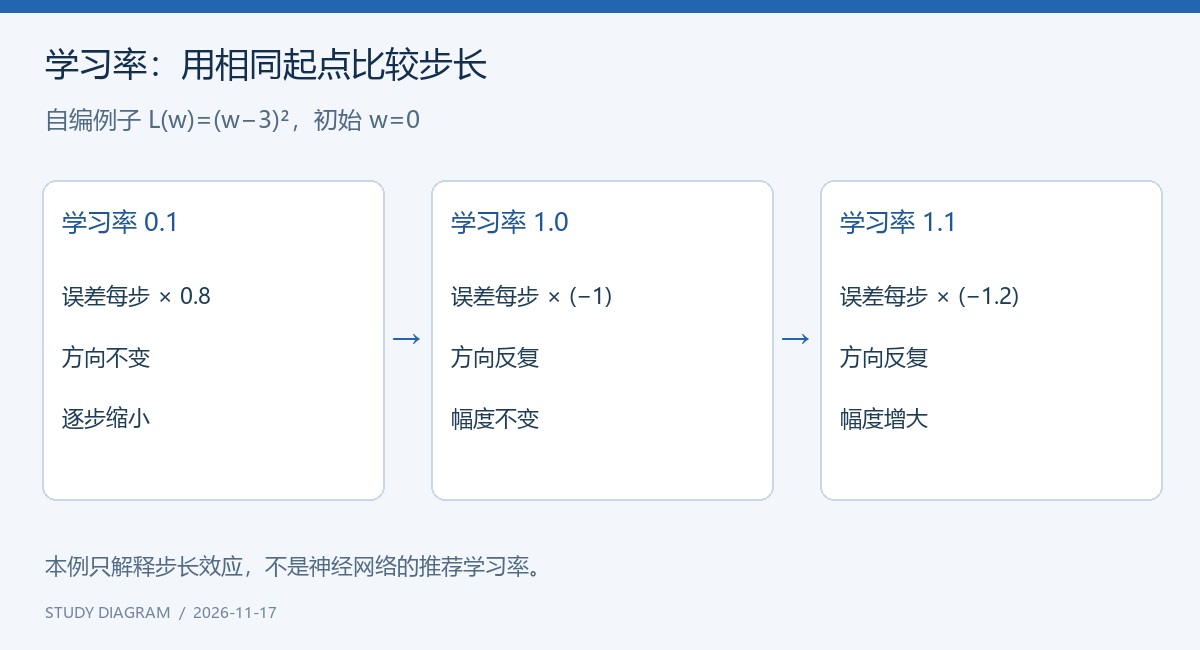
自编学习示意图;例子用于说明方法
五、选择学习率时兼顾速度与稳定性
合适的候选值应在限定训练预算内取得稳定的验证表现,而不只是让训练损失降得最快。如果两个候选结果接近,建议重复少量独立运行,观察随机波动后再下结论。记录实际用时也很必要,竞赛实践往往需要在有限资源下完成训练和提交。
学习率调度器会随训练过程改变步长,适合在基线可运行之后引入。使用时写清何时调用step、监控哪个指标、何时衰减;某些调度器按轮更新,另一些按步更新,混用调用频率会让实际曲线偏离预期。
验证集可以帮助选择学习率,但反复据此调参也会逐渐适应验证数据。保留独立测试数据或采用合适的交叉验证策略,最终报告要区分训练、调参和最终评价。不能用测试集表现倒推最优学习率,再把同一结果当作未见数据上的能力证明。
最后保存一份能复现的实验记录:数据版本、划分、优化器、初始权重、学习率、训练预算和评价结果。人工智能奥赛中的调参能力,体现在提出一个具体假设、控制其他条件、读懂实验差异,再决定下一次修改,而不是记住一个据说万能的数字。
想用实验读懂学习率与训练曲线?扫码了解AI奥赛体验课 ⇓
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
想从小函数练到独立实现,扫码领取 NOAI 备赛资料
欢迎咨询【NOAI竞赛辅导课程】