人工智能奥赛练习中,训练集用于学习,验证集用于选方案,留出测试集用于最终评估。NOAI备考尤其要练会先划分数据、再拟合预处理;比赛提供的测试文件若没有标签,就按任务要求生成预测,不能拿它反复调参。

一、拿到数据后,先确定每个文件能回答什么问题
开始建模前,先读任务说明与提交样例,列出样本标识、输入特征、目标标签和允许使用的数据。名字叫train的文件通常提供训练信息,但测试文件是否含标签、如何评价、应提交预测还是模型,都需要从本题确认。文件名不能代替任务规则,更不能把某次练习的习惯当成所有人工智能奥赛的统一要求。
在本地监督学习练习中,可以把已有标签的数据分成训练部分与验证部分,并另外保留最终测试部分。训练标签进入学习过程,验证标签用于比较候选方案,测试标签则留到方案确定后使用。如果数据太少需要交叉验证,也应把预处理放进每一折内部,而不是先在全部数据上做好变换再交叉验证。
| 数据角色 | 允许做的事 | 容易造成的误用 |
|---|---|---|
| 训练部分 | 学习填补值、缩放参数、模型参数 | 把样本标识误当有用特征直接记忆 |
| 验证部分 | 应用已学变换,比较模型和参数 | 每试一次就偷偷参考最终测试结果 |
| 留出测试部分 | 方案确定后,用于评估泛化表现 | 用测试表现挑选模型或反复改特征 |
| 比赛预测文件 | 按题目权限处理输入,生成要求的输出 | 假设一定带标签,或自行猜造标签 |
这种分工的价值在于,让模型面对它此前没有利用过的信息。若训练数据与测试数据只是形式上放在两个文件夹里,但预处理、特征筛选或参数选择早已使用了测试信息,评估仍然可能偏乐观。检查数据流,比只检查文件路径更有效。
二、标准化为什么必须先划分、后学习参数?
用一个只用于演示的自编数值例子:训练样本某项特征为150和170,按总体标准差口径计算,训练均值为160,标准差为10。验证样本180和测试样本190都沿用这两个训练参数,标准化结果分别为2和3。这个例子只展示计算顺序,两个样本并不是推荐的建模规模。
对应到常用接口,训练部分执行fit_transform,验证和测试部分执行transform。二者的区别是,前者会学习参数,后者只使用已经学到的参数。如果分别在验证集或测试集上重新fit,就把这些数据变成了另一个坐标体系,也让它们影响了处理方案。
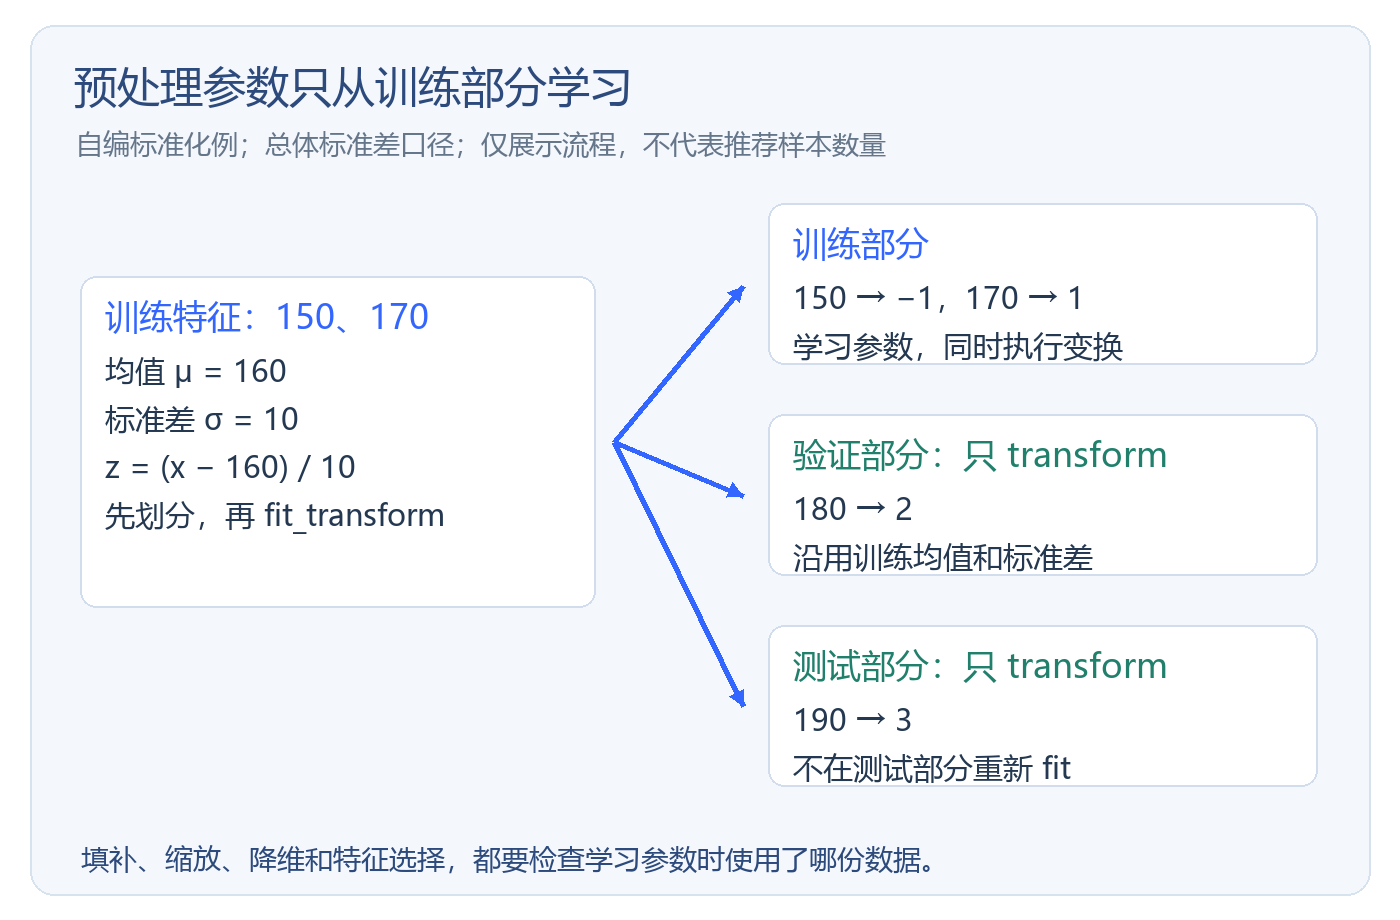
自编标准化流程示意,按总体标准差口径计算
同样的检查也适用于缺失值填补、降维和基于标签的特征选择。比如用中位数填补缺失值,中位数应从当前训练部分估计;之后处理验证样本时继续使用它。不能为了“数据更完整”,就先把全部文件拼起来估计统计量,再声称测试数据从未参与学习。
若采用scikit-learn的Pipeline,可以把预处理与模型连起来,让训练和预测沿用同一套处理步骤。但Pipeline并不会自动修复所有泄漏:如果上游特征已经包含答案、未来信息或同一人的重复记录,仍然需要先修正数据与划分方式。
三、划分数据时,先问真实预测会遇到谁
普通独立样本的分类练习,可以考虑保持类别分布的分层划分;涉及同一患者、同一设备或同一个人的多条记录时,则应考虑按组划分。否则同一对象的近似样本可能同时出现在训练和验证中,模型学到身份特征后,分数看上去很好,却未必能处理真正的新对象。
时间数据又有另一层限制。若任务是根据过去预测未来,就要警惕随机打散把未来信息带入训练过程。还要查看特征产生的时间:预测订单是否取消时,若输入包含取消后才生成的字段,即便划分方式正确,模型依旧提前看到了结果。
因此,没有适合所有任务的固定训练测试比例。选择划分方法时,应同时考虑样本数量、类别分布、分组关系和时间先后。练习记录里至少写下“为什么这样分”,而不是只留下一个随机种子;随机种子有助于复现划分,却不能证明划分合理。
四、分数突然很高时,怎样排查泄漏?
先检查目标列是否混进特征,以及有没有由目标直接计算出来的字段。再查看样本标识、重复行和近似重复样本;如果同一条数据换了文件名或被复制到另一部分,模型可能只是在识别旧样本。对异常高分,先排除这些简单原因,通常比立即更换更大模型更有价值。
随后回看所有fit发生的位置。缩放器、填补器、降维器和特征选择器都算需要审查的处理环节,不能只盯着最后一行模型训练。交叉验证时,这些步骤应在各折的训练部分重新学习,再应用到该折验证部分。把一次完整拟合得到的变换结果送入所有折,并没有保持隔离。
最后看调参过程有没有越界。公开榜单分数、留出测试分数或少量测试样例反馈,反复使用后都可能影响决策。平时可把验证结果作为日常比较依据,最终测试尽量留到方案稳定后再使用,并记录模型版本、数据版本及所采用的指标。
五、从训练完成到提交文件,还要检查什么?
先在验证部分确认评价指标的方向与定义,再执行对比赛测试输入的预测。生成结果时保留题目要求的样本顺序或标识对应关系,检查行数、列名、缺失值、标签编码和文件类型。预测值看起来合理,也可能因为错位一行而失去意义;输出格式属于解题的一部分。
NOAI相关实践需要使用Python处理数据、训练模型并理解运行结果。备考时不妨选一个小型分类任务,从读取文件一直完成到写出预测,再从头运行一次,确认没有依赖手动修改或旧变量。能清楚说明“这一步用了哪份数据、学了什么、下一步交付什么”,才算真正用对训练集和测试集。
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
NOAI新赛季备赛已开启,扫码领取NOAI备赛资料
欢迎咨询【NOAI竞赛辅导课程】