NOAI模型训练结果每次不同,常与参数初始化、数据顺序、随机增强及计算过程有关。先固定数据与评价方法,再控制随机来源,并用多次重复实验判断改动是否稳定,才能区分正常波动和程序问题。

一、先分清“分数在变”还是“评测方法在变”!
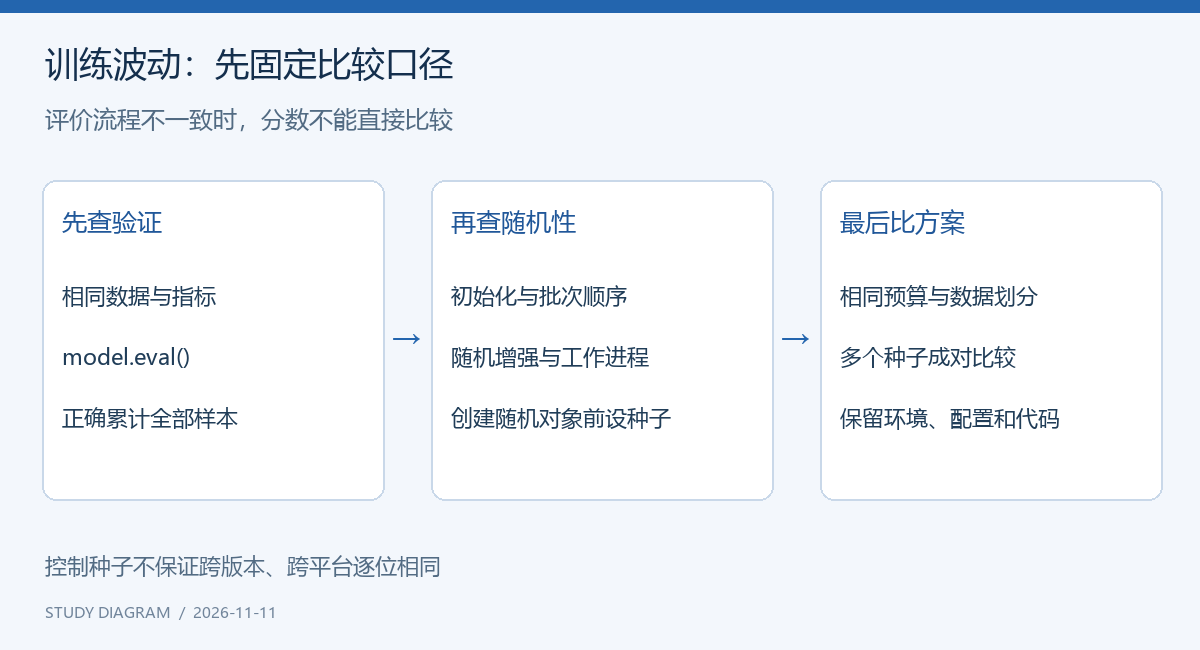
准备NOAI机器学习任务时,同一份训练代码两次得分不同,并不必然说明模型写错。训练通常包含随机过程,而验证分数还受到数据划分、预处理、评价模式和指标实现的影响。先确认比较的是同一任务、同一验证集和同一评价口径,再讨论模型优劣。
例如,第一次验证用全部样本,第二次只用了最后一个批次,即使权重完全一样,分数也可能明显变化。还有一种常见情况是把每批准确率简单平均,忽略最后一批样本量较小;更稳妥的整体准确率应计算总预测正确数除以总样本数,而不是不加权平均批次比例。
因此,排查时先保存验证集样本标识、预处理配置和指标代码。记录的是同一组事实,比较结果才有意义。不要为了让数字稳定,就反复更换验证集或只保留分数最高的一次运行。
二、训练中的随机性从哪些地方进入?
参数初始化会改变训练起点。即使网络结构、学习率与数据相同,不同初始权重也可能使优化经过不同路径,尤其在训练数据较少或模型较复杂时更明显。
批次顺序与数据增强会改变模型每一步看到的内容。随机打乱、裁剪、噪声或翻转都可能引入变化;某些增强还会影响样本标签是否仍成立,因此不能为了统一结果,直接把不适合任务的增强固定下来继续使用。
训练与评价模式也要分开。Dropout在训练时随机丢弃部分激活;BatchNorm的训练与评价行为同样不同。验证前遗漏model.eval(),可能让同一权重的输出也不稳定。torch.no_grad()减少梯度记录,但它本身不会把模型切换到评价模式,两者作用不同。
自编学习示意图;例子用于说明方法
三、先建立一个能重复检查的最小基线!
建议先关闭不必要的随机增强,固定一份数据划分,在同一软硬件环境中运行简单模型。用少量样本确认损失下降、标签对应和输出形状正常,再逐步恢复复杂配置。这样能把“模型本来较难训练”与“流程还存在明显错误”分开。
以下是训练起点的通用示例。随机状态应在创建模型、划分数据或构造需要随机采样的对象之前设置;如果另外创建独立的NumPy随机生成器,还要单独给它设置种子。
import random
import numpy as np
import torch

seed = 17
random.seed(seed)
np.random.seed(seed)
torch.manual_seed(seed)
# Create the model and other random objects after this point.
多进程数据加载时,还要检查工作进程中的随机初始化和数据加载器所用生成器。为了定位问题,可以先用单进程加载缩小范围;确认数据流程正确后,再恢复并行设置。某些运算的确定性配置会牺牲速度,甚至遇到不支持的操作,不能把开关当作无成本的万能解决方案。
四、用实验记录判断波动,不只挑最高分!
以下为自编准确率记录,三个种子使用相同的数据划分和训练预算。新方案的平均值由82.0%升至82.4%,提升为0.4个百分点,而不是4个百分点;单看其中一次的83.1%,无法说明稳定性。
| 随机种子 | 基线准确率 | 新方案准确率 | 同种子的差值 |
|---|---|---|---|
| 11 | 81.0% | 81.6% | +0.6个百分点 |
| 23 | 83.0% | 83.1% | +0.1个百分点 |
| 37 | 82.0% | 82.5% | +0.5个百分点 |
这样的成对记录有助于观察改动方向,但三次实验仍不是任何任务都适用的充分统计证明。还应查看不同类别、困难样本和训练耗时,判断提升是否集中在很小的一组样本。若验证样本少,一两道预测的变化就可能明显改变整体分数。
每次记录至少保留数据版本、划分标识、种子、参数配置、训练轮数、代码版本和指标。修改方案时尽量只改变一个关键因素,否则即使分数提高,也难解释是学习率、增强、训练时长还是结构调整带来的效果。
五、哪些现象值得优先排查?
同一权重重复验证仍明显变化时,先查评价模式、随机验证预处理、样本顺序与指标累计方式,不要马上重新训练。若评价方法使用了随机采样,也应明确随机机制与评估目的。
训练损失下降而验证突然崩溃时,检查训练和验证预处理是否一致、标签编码是否相同,以及是否选错了保存权重。验证集保持稳定,并不意味着可以参与拟合标准化参数或反复据其结果挑选最终模型;训练与验证的职责仍需分开。
换机器或软件版本后结果不同时,保存环境信息再比较。控制随机种子并不保证跨平台、跨版本得到逐位相同结果,浮点计算与具体算法也可能影响输出。目标应是实验过程可说明、差异可追踪,而不是承诺任何设备都生成同一串小数。
下一次遇到训练结果变化,可以先重复验证同一权重,再重复训练同一配置,最后才比较不同方案。把这三层问题分开,往往比不断改随机种子更快找到原因,也能让NOAI备赛中的每次调参留下可复用的证据。
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
想练习随机性排查与实验记录,扫码领取 NOAI 备赛资料
欢迎咨询【NOAI竞赛辅导课程】