少数类很少时,先数清训练集和验证集各有多少正负例,再看漏掉的正例和误报的负例。准确率相同的模型,可能一个正例也找不到,也可能找到一半以上。先诊断差异,再决定采样、加权或调整阈值。

一、先问少的是样本,还是独立的信息?
假设任务是从一百条记录中识别十条异常。训练前给每类做一份计数,同时检查样本来源。同一台设备连续拍摄的二十张近似图片,看起来有二十个正例,实际上可能只展示了一种故障。若把几乎相同的图片随机分到训练和验证两边,模型靠认出背景就能得高分,面对新设备却可能全部漏判。
有独立个体、设备或时间关系时,先按任务的真实使用方式划分,再统计每个集合里的类别。能够独立随机抽样时可考虑分层抽样,让各部分保留足够的少数类;预测未来时优先遵守时间顺序,不能为了凑比例把未来记录移入训练集。把类标签也抽查一遍,确认“零”和“一”与题目定义一致,否则后面的召回率解释会完全颠倒。
二、用一百条记录检查指标的分母
自编例子里,验证集有十个正例和九十个负例。方案甲全部猜负,答对九十条。方案乙识别出六个正例,漏掉四个,同时把六个负例误报为正,另有八十四个负例判断正确。两者准确率都是百分之九十。要知道谁更适合某个任务,必须先读题目采用的指标,以及漏报和误报各自带来的影响。
| 验证结果 | 全部猜负 | 方案乙 |
|---|---|---|
| 真正例与漏报 | 零与十 | 六与四 |
| 误报与真负例 | 零与九十 | 六与八十四 |
| 正类召回率 | 零 | 百分之六十 |
方案乙共报出十二个正例,其中六个是真的,因此正类精确率为一半。正类召回率则是在十个真实正例中找出了六个。二者的调和平均数 F1 约为零点五四五。如果一个正例都没有预测,精确率的分母为零,应说明评分程序如何约定;不能把没有预测正例解释为“从未误报,所以能力完美”。
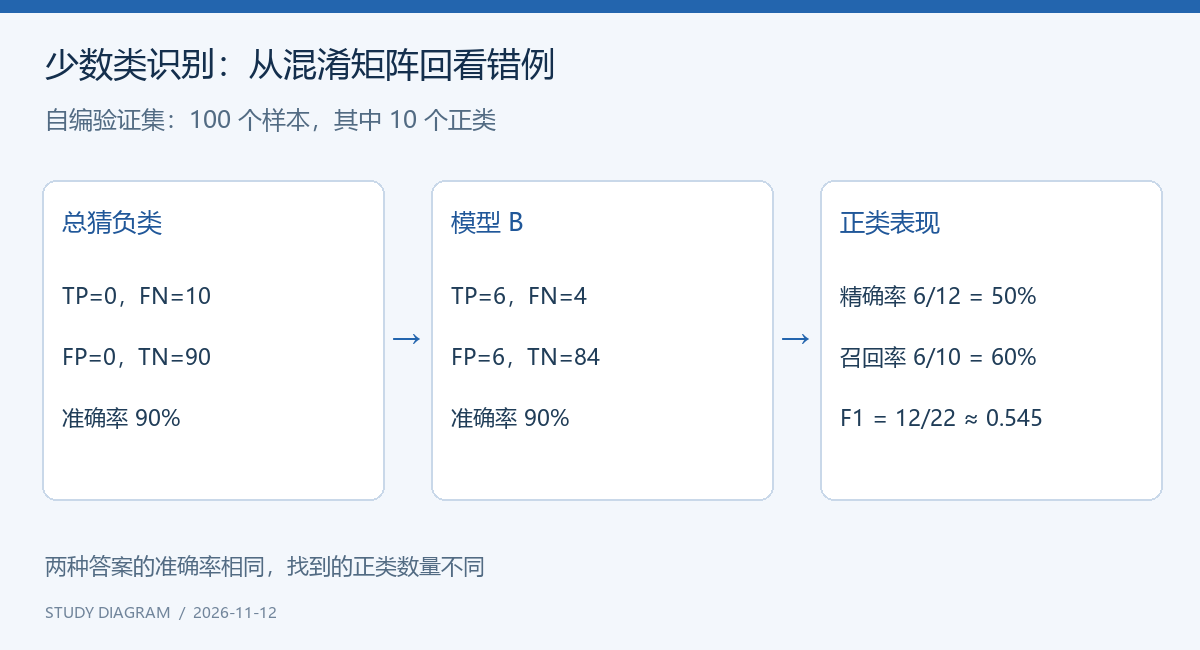
自编学习示意图;例子用于说明方法
三、把三个改法放在各自能够起作用的位置
类别加权改的是训练损失。让一个少数类样本分错时付出较高代价,可能促使模型划出更大的正类区域。先保留等权重基线,用同一验证集比较。权重太大时,误报可能迅速增加;若几条错标正例还被放大,效果尤其不稳定。验证时仍按题目指定的指标计算,训练权重不能擅自带入最终评分。
重采样改的是训练时看到的样本。复制少数类便于模型在小批次里接触到它们,却不会凭空增加新的故障类型。欠采样能降低多数类的支配程度,也可能删掉最接近决策边界的难例。两种操作都应放在数据划分之后,交叉验证时只操作当折训练部分。验证集保留原任务中的分布,否则对误报数量的估计可能过于乐观。
调整阈值改的是从分数到类别的决定。若任务允许自行设阈值,保留同一模型的验证分数,逐个候选阈值统计真正例、误报和漏报。降低阈值通常能多找到一些正例,也可能增加复核负担。若正式提交要求概率或用排序指标评分,先照题面输出连续分数,过早压成零和一会丢掉排序信息。
四、用错例单决定下一次实验
在上述十个正例的验证集里,多找回一个就会让召回率跳十个百分点。看见一次跳升,先列出新增的那一条,检查它与训练样本有无重复、标签是否可靠,再讨论改善能否扩展到新样本。保留不同合理划分或不同种子的结果和原始计数,比只摘取一次最好分数更能说明问题。
一次训练记录至少应让同伴回答三个问题:与哪个基线比较,只改变了什么,哪一批样本的判断发生了变化。如果两种方法得分接近,逐条查看它们意见不同的样本。例如一个方法擅长识别白天拍摄的异常,另一个在暗光下少漏报,就有理由按场景补充数据,或者重新检查图像预处理。等错误有了具体面貌,再投入时间扩大模型,实验才有可验证的方向。
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
想用混淆矩阵练习分类诊断,扫码领取 NOAI 备赛资料
欢迎咨询【NOAI竞赛辅导课程】