检查模型预测,先对样本身份,再对输出含义,最后用带真实标签的验证集分析错误。预测文件能打开、行数正确,只说明有了一份可以继续检查的文件。

一、三个一样长的数组也能交错答案
假设一项自编二分类任务要求按样例表提交标签。样例表从上到下列出 K7、K2、K9,预测程序为了把相似长度的输入放在一起,实际处理顺序是 K2、K9、K7,给出的类别依次为零、一、一。现在把这三个数字原样贴到样例表右侧,看起来每一行都有答案,连两个类别的数量也和预测时完全一致。可是第一行已经把别人的预测交给了 K7。
恢复对应关系要依靠推断时留下的编号。把 K2 对应零、K9 对应一、K7 对应一记在临时对照表里,再按样例表的编号依次查找,正式输出应为一、零、一。这里并没有重新训练模型,也没有修改任何单个样本的分数,改动只发生在数据表的连接步骤。若中间只留下了三个数而丢掉了编号,再按当前表格猜测顺序没有依据,应该让推断程序带着编号重新输出一次。
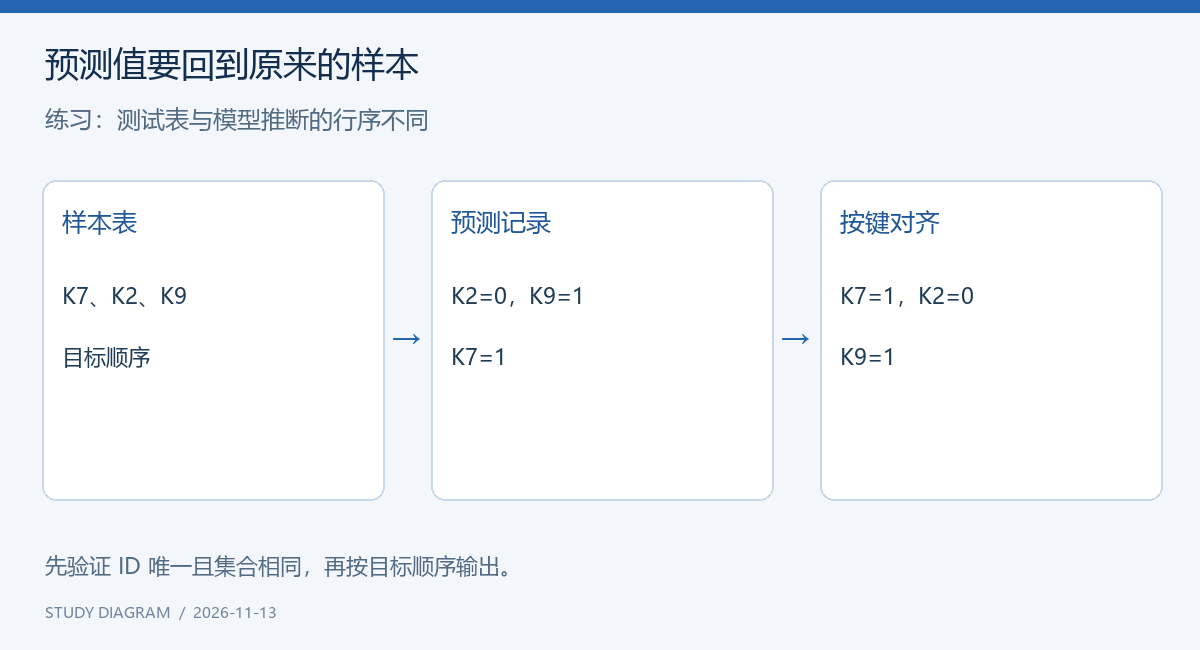
自编学习示意图;例子用于说明方法
给每张表做两项独立检查。第一项是编号是否各自唯一,第二项是两边编号的集合是否相同。只检查集合,重复一行的错误可能藏在里面;只检查行数,一个缺失的编号也可能恰好被一个重复编号顶替。编号若含前导零,读取表格时应把它当作字符串,否则两个本来不同的编号会在读入时被合并。
二、看懂这一列数字代表什么
有的任务需要类别编号,有的需要指定类别的概率,还有的要求连续值。以二分类为例,模型输出两列分数时,第二列对应哪个类别取决于训练时采用的标签映射。自行约定“第二列一定代表通过”,遇到类别映射相反的训练数据,即使程序运行顺畅也会把结论颠倒。最好用一个已知类别的示例贯穿编码、训练和解码,确认三处使用同一本映射表。
| 检查对象 | 可以构造的反例 | 通过条件 |
|---|---|---|
| 编号对应 | 调换模型的推断顺序 | 按编号还原后每个预测仍跟原样本走 |
| 取值范围 | 在概率列放入一点二 | 能指出哪一行超出零到一 |
| 类别映射 | 把零和一对应的名称互换 | 解码后的类别与任务说明相符 |
| 字段含义 | 把正类概率换成最大类别概率 | 按列名与定义识别差别 |
例如某样本的正类概率为零点二,负类概率为零点八,“模型最有把握的类别的概率”是零点八。若提交列名明确定义为正类概率,就应该交零点二。还可以检查是否出现空值、无穷大或超出约定的类别编号。对多标签任务,多项概率可以同时较高,不能把单标签多分类中常用的“每行概率和为一”无条件用于所有预测表。
三、验证集先看错在哪些样本
在保留真实标签的一小份验证集上,选取几条模型很有把握却预测错误的记录,和几条刚过阈值的记录分别查看。前者常能暴露读错文件、标签解释相反或者特殊输入缺失的问题;后者适合观察决策边界附近的信息究竟够不够。每发现一例,先把原始输入、处理后输入、模型原始输出和解码结果写在同一行,才能分清下一步应查数据还是查模型。
例如训练阶段去掉了文本前后的空格,而验证时又多删了一个有辨识度的符号。比较预处理前后的样本就能看到文字被改变。若所有空文本恰好都得到同一预测,不足以证明模型偏爱某个类别,先看看这些空文本是否一开始就为空,还是读取程序漏掉了字段。相反,若预处理一致且人工也难判断,可单列为模糊案例,避免只为这几个样本修改整个流程。
四、用一次扰动验证提交过程
保存一个很小的固定输入,先按原顺序预测一次,再把行顺序倒过来重复一次。在关闭训练时的随机行为、逐条样本独立推断且数值容差合理的条件下,按编号对齐后的结果应相符。若只有位置不同,检查数据写回;若单条样本本身的分数显著不同,再查评估模式、批次依赖或预处理。不要直接把新旧文件按原行号相减,否则测试会重新制造开头的错位。
提交前从最终导出的文件重新读入数据,抽查首行、末行和中间一行,确认列名、行序、有效小数与编号都保留下来。验证集用于选择阈值或比较模型,待提交的测试集通常没有可见真值,因此无法凭它计算真实准确率。保留本次验证使用的划分、类别表和导出文件,下次看到分数反常时,就有一条可以从最终表格倒查回原样本的路径。
🔥 AI 奥赛体验课,限时 9.9 元 (原价649元)
翰林名师亲授,一课打通 AI 四大领域,零基础也能学,扫码即可报名咨询 ⇓

点击右侧文字,可获得更多在线练习题资源:>>> NOAI在线水平测试
想练习逐行核验预测结果,扫码领取 NOAI 备赛资料
欢迎咨询【NOAI竞赛辅导课程】